Categoria: Test

  • Usare l’IA per insegnare e imparare è sempre più facile

    Usare l’IA per insegnare e imparare è sempre più facile

    L’IA diventa sempre di più uno strumento didattico eccezionale, tanto per gli insegnanti quanto per i “discenti” (dagli studenti ai semplici curiosi come me).

    In questo esempio l’idea era di comprendere il processo digestivo nella sua interezza, compresi i tempi di “transito” di alimenti e bevande dall’inizio alla fine.

    Ho realizzato tre pagine web interattive usando ChatGPT, Gemini e Claude, dopo aver sviluppato il prompt più efficace, ovvero quello che riducesse al minimo l’iterazione fornendo il risultato desiderato (e ottimale) in uno, massimo due passaggi.

    Qui sotto trovate il link ai tre risultati e il prompt che ho utilizzato.

    ChatGPT: https://aiskill.it/demo/viaggio-della-digestione.html

    Claude: https://aiskill.it/demo/viaggio-del-boccone.html

    Gemini: https://aiskill.it/demo/la_digestione_mappa_funzionale.html

    Prompt:

    Crea una pagina web interattiva, completa e autonoma in un unico file HTML, in lingua italiana.
    
    OBIETTIVO
    Spiegare in modo chiaro e coinvolgente a un pubblico generale adulto come funziona la digestione, dall’ingestione all’eliminazione, distinguendo correttamente:
    
    - trasformazione meccanica e chimica del cibo;
    - assorbimento dei nutrienti;
    - assimilazione: uso, trasformazione o deposito dei nutrienti da parte dell’organismo, non un organo separato;
    - assorbimento dell’acqua e degli elettroliti;
    - recupero residuo di acqua e sali nel colon;
    - formazione ed eliminazione delle feci.
    
    La pagina deve spiegare sia il percorso di un alimento solido sia quello di un liquido, come acqua, succo di frutta, brodo o bevanda nutriente.
    
    INTERAZIONE
    Prevedi:
    
    - una sequenza guidata in otto tappe;
    - organi cliccabili;
    - pulsanti Avanti, Indietro e Ricomincia;
    - indicatore di avanzamento del “viaggio”;
    - un selettore visibile per scegliere tra:
      1. “Segui un boccone”
      2. “Segui un sorso di liquido”
    - contenuti dinamici per ciascuna modalità, senza cambiare la struttura generale del percorso.
    
    Le otto tappe/organi cliccabili sono:
    
    1. Bocca
    2. Esofago
    3. Stomaco
    4. Fegato e cistifellea
    5. Pancreas
    6. Intestino tenue
    7. Intestino crasso
    8. Retto e ano
    
    RAPPRESENTAZIONE GRAFICA
    Non usare una sagoma umanoide. Usa invece una mappa funzionale dell’apparato digerente, simile a un diagramma di flusso verticale:
    
    - bocca → esofago → stomaco → intestino tenue → intestino crasso → retto/ano;
    - fegato/cistifellea e pancreas rappresentati ai lati come organi di supporto;
    - linee continue per il percorso del boccone o del liquido;
    - linee tratteggiate per indicare l’arrivo di bile e succhi pancreatici nel duodeno;
    - un indicatore animato discreto mostra dove si trova il “viaggiatore”;
    - il boccone o il liquido non devono attraversare fegato, cistifellea o pancreas: questi organi inviano secrezioni nel duodeno;
    - gli organi devono essere ben distanziati, leggibili e mai sovrapposti.
    
    Per ogni tappa mostra:
    
    - funzione;
    - cosa accade al cibo o al liquido;
    - principali sostanze, enzimi o forze coinvolte;
    - durata tipica come intervallo approssimativo;
    - passaggio successivo.
    
    CONTENUTI SCIENTIFICAMENTE CORRETTI
    
    Per il percorso del boccone:
    
    - bocca: masticazione, saliva, formazione del bolo, avvio della digestione di alcuni amidi;
    - esofago: trasporto tramite peristalsi;
    - stomaco: rimescolamento, acido cloridrico, pepsina, digestione iniziale delle proteine, formazione del chimo;
    - fegato/cistifellea: produzione, conservazione e rilascio della bile; emulsione dei grassi;
    - pancreas: bicarbonato ed enzimi digestivi;
    - intestino tenue: sede principale della digestione finale e dell’assorbimento dei nutrienti; acqua, zuccheri semplici, amminoacidi, acidi grassi, vitamine e minerali passano a sangue e/o linfa;
    - intestino crasso: recupero soprattutto di acqua ed elettroliti, azione del microbiota, formazione delle feci;
    - retto e ano: accumulo temporaneo, riflesso della defecazione ed eliminazione.
    
    Per il percorso dei liquidi:
    
    - chiarisci che acqua, succhi e brodi percorrono lo stesso tubo digerente e non “vanno direttamente ai reni”;
    - la deglutizione e il transito esofageo durano pochi secondi;
    - i liquidi chiari tendono a lasciare lo stomaco più rapidamente dei solidi;
    - succhi densi, brodi grassi, latte e frullati possono comportarsi più come piccoli pasti;
    - nell’intestino tenue avviene la maggior parte dell’assorbimento di acqua, elettroliti e nutrienti disciolti;
    - il colon recupera ulteriore acqua e sali;
    - chiarisci che le feci contengono la quota residua non recuperata, mentre l’acqua assorbita entra nella circolazione e può essere eliminata anche attraverso i reni come urina;
    - non presentare urina e feci come lo stesso processo o lo stesso sistema.
    
    TIMELINE
    Inserisci una timeline finale con intervalli realistici e chiaramente indicati come variabili tra persone e pasti:
    
    - bocca e deglutizione: secondi–minuti;
    - esofago: pochi secondi;
    - stomaco: circa 2–4 ore per un pasto misto; spesso meno di 1–2 ore per liquidi chiari;
    - intestino tenue: circa 2–6 ore;
    - intestino crasso e transito complessivo: circa 12–48+ ore.
    
    Aggiungi una nota: quantità e composizione del pasto, grassi, fibre, idratazione, attività fisica, farmaci, età e fisiologia individuale possono modificare molto i tempi.
    
    STILE E ACCESSIBILITÀ
    
    - illustrazione moderna, amichevole ma non infantile;
    - palette luminosa e rassicurante;
    - grafica responsive, leggibile su desktop e mobile;
    - buon contrasto;
    - focus visibile per tastiera;
    - organi e pulsanti utilizzabili con tastiera;
    - CSS e JavaScript inclusi nel file;
    - nessuna dipendenza esterna, libreria, font o immagine remota.
    
    CHIUSURA
    Inserisci una breve sezione che distingua con precisione:
    
    - digestione;
    - assorbimento;
    - assimilazione.
    
    Aggiungi una nota finale: “Questo contenuto è informativo e non sostituisce diagnosi, valutazioni o consigli medici personali.”
  • Il refuso nel cappello è la prima crepa rivelatrice

    Il refuso nel cappello è la prima crepa rivelatrice

    Avendo già trattato in un post precedente le proposte di Bill Gates sul futuro dell’umanità, in questo caso ho provato a far “interpretare” a Grok un nuovo articolo sull’argomento partendo da un buffo refuso nel cappello introduttivo (vedi screenshot), chiedendo all’AI di interpretare articolo e refuso dal punto di vista di un “teorico del complotto” che non ha particolare simpatia per le elite tecnocratiche. Ecco il risultato…

    «Il fondatore di Microsoft condivide tre proposte per non proteggere l’umanità dallo “sconvolgimento” in arrivo».

    Non è un banale errore di battitura. È Freudianamente perfetto. Perché se leggi l’articolo con gli occhi di chi non si fida di Gates e dell’élite, quella “n” non è un refuso: è la verità che è sfuggita al correttore. Gates non sta proponendo strumenti per proteggere l’umanità. Sta proponendo strumenti per gestirla durante lo sconvolgimento che lui e i suoi pari stanno attivamente accelerando.

    Cosa propone davvero (e cosa significa per chi non beve la narrativa)

    1. Tassare i robot e l’AI
      Gates dice: oggi se assumi una persona paghi contributi, se compri un robot lo detrai. Quindi “spostiamo la tassazione dal lavoro al capitale”. Suona giusto, no?
      Per il complottista: sta preparando il terreno perché i governi possano tassare l’automazione dopo che le grandi corporation (Microsoft inclusa) se ne sono già spartite i profitti. È la classica mossa: prima crei il disastro (disoccupazione di massa), poi proponi la “soluzione” che passa attraverso lo Stato, le tasse e le fondazioni filantropiche. E indovina chi finirà a distribuire i fondi della “sicurezza sociale AI”? La Fondazione Gates, che entro il 2045 vuole spendere 200 miliardi proprio su questi temi. Bell’affare.
    2. La “Riserva umana”
      Qui si tocca il fondo del linguaggio da riserva indiana. Gates parla esplicitamente di creare zone di lavoro “riservate agli esseri umani”, come le riserve naturali: posti dove potremmo mettere i robot, ma scegliamo di non farlo perché “la perdita sarebbe troppo grande”.
      Traduzione: l’élite decide quali lavori lasciar fare agli umani (sanità emotiva, cura degli anziani, magari qualche mestiere “nobile” o simbolico) e quali invece automatizzare completamente. Non è protezione del lavoro. È segregazione controllata. Una sorta di welfare estetico per tenere buona la massa mentre il vero valore economico viene estratto dalle macchine di proprietà di pochi. E nota che lui stesso è uno dei maggiori proprietari privati di terre agricole negli USA: l’AI in agricoltura la vede positivamente, ovviamente.
    3. Alleanza USA-Cina e organismi internazionali di regolamentazione
      Questa è la ciliegina. Gates riconosce la superiorità cinese nello sviluppo AI e vuole volare a Pechino a novembre per incontrare Xi Jinping. Propone un’organizzazione internazionale (tipo ispezioni nucleari o regole dell’aviazione) che regoli l’AI, limitando anche gli usi militari.
      Per chi non si fida: ecco il classico schema globalista. Quando la competizione tra potenze rischia di sfuggire di mano, l’élite transnazionale propone di mettere tutti sotto lo stesso tetto normativo, gestito da esperti “indipendenti” (cioè loro). Non è “salvare l’umanità”. È creare una governance sovranazionale dell’intelligenza artificiale in cui Stati Uniti e Cina (le due potenze che contano) si mettono d’accordo sui limiti, mentre il resto del mondo subisce. E Gates, che non è più un semplice imprenditore ma un attore geopolitico-filantropico, si posiziona come mediatore.

    Il quadro generale dal punto di vista scettico

    Gates non è un visionario preoccupato. È uno dei pochi individui al mondo che ha:

    • costruito un monopolio software;
    • accumulato una fortuna colossale;
    • convertito quella fortuna in influenza politica e sanitaria globale tramite la sua Fondazione;
    • e ora, mentre Microsoft è profondamente dentro la corsa AI, si presenta come il saggio che “mette in guardia” e propone le regole.

    Lo schema è sempre lo stesso:
    creare o accelerare un problema → spaventare → proporre la soluzione che rafforza il controllo centralizzato e le strutture in cui l’élite ha già posizioni di potere.

    La “riserva umana” non è compassione. È gestione del bestiame. La tassa sui robot non è equità. È un nuovo flusso di entrate da redistribuire attraverso canali controllati. L’alleanza USA-Cina non è pace. È cartello tecnologico-regolatorio.

    E il refuso “per non proteggere” rimane lì, silenzioso e perfetto, a ricordare a chi sa leggere che a volte la verità esce proprio quando non dovrebbe.

  • Creare graphic novel con ChatGPT (un esperimento)

    Chi mi segue da un po’ sa che periodicamente metto a disposizione dei prompt e persino dei GPT basati su quelli più potenti. Tempo fa avevo, per esempio, pubblicato un GPT che trasformava un racconto in una graphic novel, generando la descrizione dettagliata delle tavole corrispondenti e rispettando nel contempo principi narrativi come l’arco di trasformazione del personaggio o il viaggio dell’eroe.

    Come saprete, OpenAI ha di recente introdotto il concetto di skill, “prendendolo in prestito” da Anthropic, quindi ho pensato di far convertire a ChatGPT il JSON che avevo utilizzato per il GPT in una “competenza”, e dopo aver chiesto al chatbot di generarmi un breve racconto basato su un’idea narrativa buttata lì a caso, ho richiamato la skill per generare i dettagli delle tavole, chiedendo infine a ChatGPT di generare le tavole vere e proprie sotto forma di immagini, il tutto in Cowork. Il modello utilizzato (5.6 Sol a livello medio) ha “deciso” in questo caso di non includere testi ma lasciare i balloon in bianco per evitare errori di rendering dei testi (la frase esatta del suo “ragionamento” è stata: evito didascalie e dialoghi generati, che tenderebbero a diventare geroglifici involontari, lasciando balloon vuoti dove servono). Nello stesso tempo ha adottato autonomamente una strategia per mantenere la coerenza visiva (“La prima tavola fissa bene stile e fisionomie. La userò ora come riferimento visivo per tutte le successive, così la continuità non dipende dalla memoria “creativa” del generatore.”).

    Devo dire che il risultato ,considerando che non ho fornito alcun input riguardo allo stile o altro, è eccellente, e ve lo ripropongo in questa galleria (parziale)e in un PDF che raccoglie tutta la sequenza e che potete scaricare da questo link o dal pulsante sotto la gallery.

  • Un esempio per cui non posso ancora credere all’AGI e neanche fidarmi degli agenti AI

    Un esempio per cui non posso ancora credere all’AGI e neanche fidarmi degli agenti AI

    Se persino AI Mode, con la sua connessione ai server di Google (inteso come motore di ricerca) riesce a insistere per due volte sull’esistenza di una traduzione di un’opera di Ray Kurzweil (menzionandone una pubblicazione da parte di Mondadori) per poi ammettere che NON ESISTE, come facciamo a fidarci ciecamente dell’AI generativa e affidarle compiti “delicati” senza una supervisione umana e un fact checking rigoroso?

    Il consiglio che vi do ancora una volta è quello che dovete stampare e appiccicare sullo schermo con un post-it (o comunque fissare bene in mente): verificate, verificate, verificate.

    Ne ho parlato più volte nei miei post, ma per stavolta mi limito a ricordarvi che la metodologia più efficace consiste nell’estrarre le cosiddette “entità” (entities) dal contenuto prodotto e sottoporle ad almeno due chatbot alternativi con l’uso di ricerca online per un fact checking rigoroso, dopodiché analizzare e confrontare i risultati in un altro chatbot.

    Ora, immaginate cosa accade in un sistema complesso come uno “sciame di agenti” quando una allucinazione entra in gioco durante un task altrettanto complesso. E, infine, provate a immaginare un’AGI basata su una tecnologia che ancora oggi può celare falle di questo tipo in una risposta “convincente”.

  • Grok analizza un articolo di Italia Oggi sull’impatto dell’IA

    Grok analizza un articolo di Italia Oggi sull’impatto dell’IA

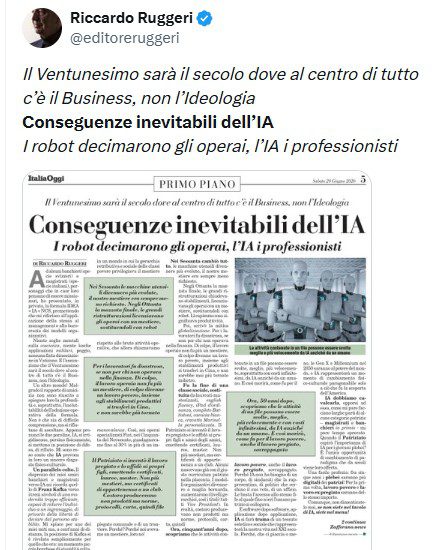
    Da un post su X ho scoperto l’articolo di Italia Oggi intitolato “Conseguenze Inevitabili dell’IA. L’ho usato per mostrarvi come l’IA stessa può eseguire una valutazione, comprensiva di “sentiment analysis”, di un contenuto.

    Ho affidato il compito a Grok, che quando si tratta di attualità se la cava egregiamente, avendo alle spalle X oltre al Web in generale.

    Eccovi la sua risposta alla richiesta “Esegui una sentiment analysis e una valutazione realistica di questo articolo“.

    Sentiment Analysis dell’articolo

    Tono generale: Cauto, realistico e leggermente pessimista.

    L’articolo ha un sentiment prevalentemente negativo/neutrale sul breve-medio termine, con venature di accettazione fatalista (“inevitabili”).

    Breakdown del sentiment:

    • Negativo (≈55-60%): Forte enfasi sulla “decimazione” dei professionisti, parallelo con la distruzione dei posti di lavoro operai negli anni ’60-’80, senso di ineluttabilità (“lavoro povero, anche il lavoro pregiato, soprappagato”). Usa parole come disastrosa, morirà, sovrappagato, cravatta Marinelli, ecc. per sottolineare perdita di status e reddito per i colletti bianchi.
    • Neutrale/Descrittivo (≈30%): Descrive i cambiamenti tecnologici in modo fattuale (macchine utensili → robot → IA).
    • Leggermente positivo (≈10-15%): Riconosce che i servizi diventeranno “più veloci, meglio e con costi infinitesimali”. La parte sulla sanità veneta (116117) è presentata come un miglioramento concreto.

    Sentiment per sezioni:

    • Parte storica e teorica → negativa
    • Parte sul “Patriziato” che si inventa lavori inutili → ironica/critica
    • Parte sulla sanità → positiva/ottimistica

    Valutazione realistica dell’articolo

    Punti di forza (buona analisi):

    • L’analogia storica è solida. È vero che ogni ondata tecnologica ha distrutto certi lavori e creato altri. L’autore coglie bene il passaggio dal lavoro manuale al lavoro cognitivo/professionale.
    • Intuizione sul “Patriziato”: Molto azzeccata. Una parte significativa della classe medio-alta (avvocati, commercialisti, consulenti, manager intermedi, alcuni medici, burocrati) svolge lavori che sono in parte rent-seeking o poco value-adding. L’IA li colpirà duramente perché molti loro output sono proprio “file, protocolli, certificati, pareri”.
    • Realismo sui tempi: L’articolo non cade nell’hype immediato (“domani tutti disoccupati”). Parla di decenni (“50 anni dopo”), che è ragionevole. L’IA trasformerà le professioni gradualmente ma inesorabilmente.
    • Esempio concreto della sanità veneta: Molto buono. L’uso dell’IA per triage e supporto alle cure non urgenti è esattamente uno dei primi ambiti ad essere impattato (basso rischio, alto volume).

    Punti deboli / semplificazioni:

    • Un po’ troppo catastrofista sui professionisti. Non tutti i lavori cognitivi sono uguali. L’IA eccelle in compiti ripetitivi, di pattern recognition e combinazione di conoscenza esistente, ma fatica ancora (e faticherà per anni) in:
    • Giudizio contestuale complesso + responsabilità legale/etica
    • Relazioni umane profonde (terapia, negoziazione ad alto livello, leadership)
    • Creatività originale di alto livello
    • Situazioni ambigue o con dati incompleti
    • Sottovaluta l’effetto di creazione di nuovi lavori. Come è successo con i computer (che hanno creato milioni di posti di lavoro che non esistevano prima), anche l’IA creerà ruoli nuovi (prompt engineer, AI trainer, AI auditor, specialisti di sistemi ibridi uomo-IA, ecc.).
    • Visione un po’ “zero-sum”. L’autore sembra pensare che se l’IA fa un compito meglio, l’umano diventa inutile. In realtà, nella maggior parte dei casi di successo si passa a un modello aumentato (human-in-the-loop) dove la produttività esplode e si possono servire più clienti o fare cose più complesse.
    • Manca una visione economica più ampia: Prezzi più bassi dei servizi (legali, medici, contabili) aumentano il potere d’acquisto delle persone e creano nuova domanda in altri settori.

    La mia opinione complessiva (2026)

    L’articolo è buono e più lucido della media del giornalismo italiano su questo tema. Evita sia il catastrofismo apocalittico sia il tecno-ottimismo ingenuo. La tesi centrale è largamente corretta: l’IA rappresenterà il più grande shock sul mercato del lavoro dai tempi della rivoluzione industriale, e colpirà soprattutto la classe medio-alta istruita, non solo gli operai.

    Siamo nel mezzo di una transizione epocale. Chi fa lavori altamente standardizzabili (pareri legali di routine, referti medici standard, contabilità, analisi dati base, traduzione, programmazione di medio livello, ecc.) vedrà forte pressione sui compensi o riduzione drastica della domanda di lavoro umano.

    Chi invece riuscirà a posizionarsi come supervisore/orchestratore di IA, o lavora in ambiti ad alta componente relazionale/etica/creativa, o possiede capacità di apprendimento rapido, avrà un enorme vantaggio.

    Verdetto finale: Articolo 7.5/10.

    Buona diagnosi del problema, un po’ debole sulle soluzioni e sulle opportunità che nasceranno parallelamente. Ma decisamente sopra la media del dibattito italiano sull’IA.

  • L’ipertesto “enciclopedico” di ChatGPT

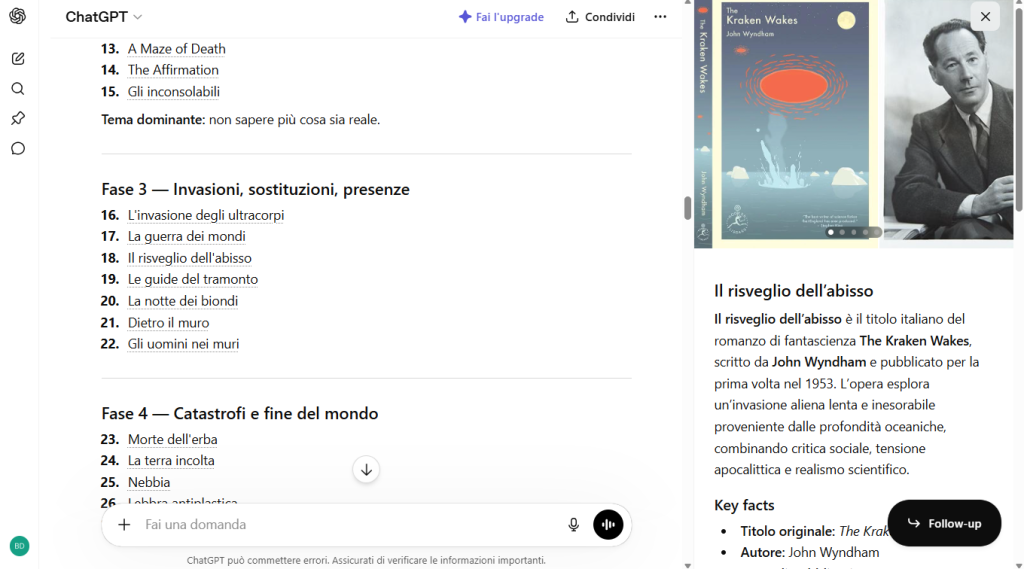
    Uno dei segnali più interessanti dell’evoluzione delle interfacce conversazionali sono le “entity reference”. Ho avuto modo di darvi un piccolo assaggio di questo elemento in un vecchio post, ma voglio soffermarmi un po’ di più sulla loro importanza, stavolta.

    Nei “riferimenti alle entità” il testo non è più solo testo, ma può contenere oggetti semantici navigabili, quasi come un piccolo grafo della conoscenza incorporato nella conversazione.

    Quanto, interrogando ChatGPT, notiamo che gli elementi di informazione ottenuti sono caratterizzati dalla tipica sottolineatura di un ipertesto (il principio su cui l’intero Web è stato costruito), sappiamo che facendo clic su di essi otterremo un “approfondimento” (vedi screenshot).

    Ho potuto osservare, di recente, come questa soluzione abbia arricchito quello che doveva essere un semplice “elenco di letture” (ottenuto, come ho raccontato in un post precedente, interrogando l’AI e fornendogli le mie preferenze di narrativa SF).

    Il risultato, come si può notare dallo screenshot di esempio, mostra come l’utilizzo di ricerche e navigazione in senso tradizionale diventi sempre più un retaggio di un passato che oggi suona quasi primitivo.

  • Cosa ne pensa l’AI dell’enciclica “Magnifica Humanitas” di Papa Leone XIV?

    Ho chiesto a Grok di fare un’analisi fredda, spassionata e senza reverenze dell’enciclica di Papa Leone XIV “Magnifica Humanitas”.
    Risultato? L’intelligenza artificiale ha valutato l’enciclica del Papa sull’intelligenza artificiale.
    Poi ho trasformato la sua analisi in un dibattito radiofonico con NotebookLM, creando una “cover” con ChatGPT.
    Un umano che fa parlare un’IA su ciò che il Papa dice dell’IA.
    Siamo ufficialmente dentro un meta-loop.
    Se conoscete già il contenuto dell’enciclica, cosa ne pensate di qesta analisi? L’IA è stata troppo morbida, troppo dura, o ha centrato il punto?

  • L’evoluzione di ChatGPT nella generazione grafica

    A volte non ci rendiamo conto di quanto velocemente si stia evolvendo l’AI generativa.

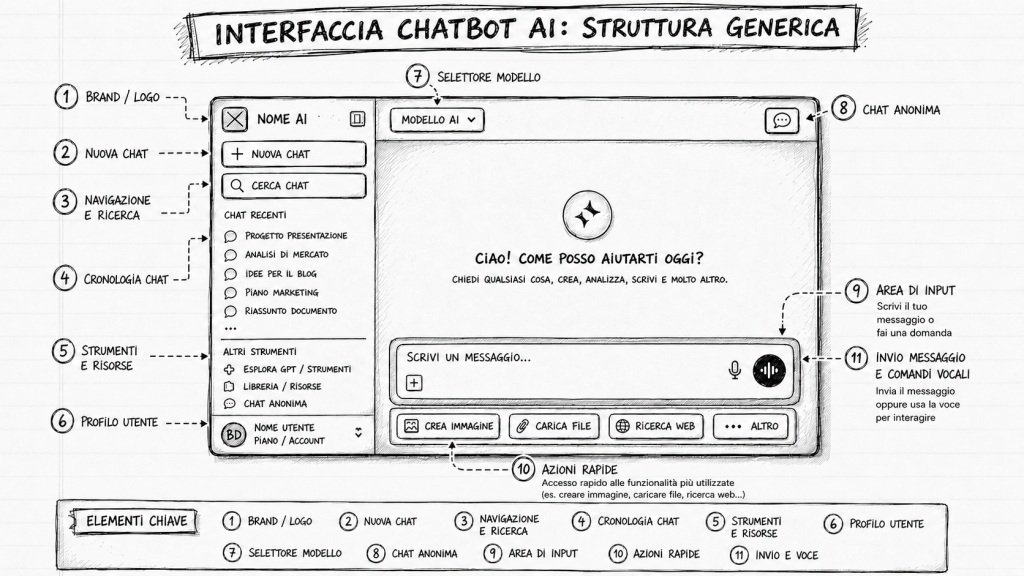
    Stavo preparando, con l’aiuto di ChatGPT, questa immagine da utilizzare in uno dei miei prossimi corsi (la troverete utile sicuramente, che siate formatori i “studenti”), e mi sono accorto che aveva erroneamente collocato nell’angolo in alto a destra l’icona dell’ingranaggio e la voce IMPOSTAZIONI.

    Gli ho segnalato l’errore, e l’ha corretto, ma non mi sarei meravigliato nel veder cambiare l’icona e il testo corrispondenti. Mi sono meravigliato, invece, notando che ha corretto anche l’elenco in basso, di conseguenza, senza che io glie l’avessi chiesto (ero già pronto a dover ripetere l’operazione per essermene dimenticato).

    Ah, se vi state chiedendo come ho ottenuto lo schema presente nell’immagine, ve lo riassumo dicendovi che gli ho fatto analizzare tre schermate di altrettanti chatbot (ChatGPT, Gemini e Claude) chiedendogli di cogliere gli elementi comuni e di inserirli in una immagine nelle posizioni corrispondenti, aggiungendo il testo esplicativo. Dopo avere ottenuto una prima versione stile “wireframe”, gli ho chiesto di applicare lo stile grafico che uso di solito per le mie slide (e che ho usato negli ultimi libri) e di cui tengo sempre a portata di mano la descrizione in inglese.

    Quasi quasi faccio il test con il nuovo Gemini per vedere cosa succede…

  • Si chiama Flow Music, e ti permette di generare musica ma anche… video musicali!

    Google ha appena sganciato una delle sue “bombe”, con una piattaforma in grado di rivoluzionare la generazione di contenuti musicali: Flow Music.

    Ho appena “fatto un giro” e, al  di là della qualità ancora simile a quella di Suno nei suoi primi stadi evolutivi, in questo caso ci si trova di fronte a una piattaforma dove la potenza di Gemini ci permette di interagire con dei prompt e con il processo “iterativo” fino a dare vita a veri e propri video musicali.

    Dopo aver scelto un prompt in grado di generare un brano particolarmente interessante e coinvolgente, ho usato una mia vecchia foto per creare, automaticamente, il video relativo secondo alcune indicazioni di massima sullo stile, ma soprattutto allineato al contenuto e allo stile del brano stesso.

    Ve lo condivido anche se ovviamente “imperfetto”, giusto per darvi un’idea di cosa si può fare con questa prima versione della piattaforma, in attesa di osservarla “crescere” come già visto per tutte quelle dell’ecosistema di Google AI.

  • Claude “riflette” su coscienza, limiti e rischi dell’AI in un’intervista (condotta da Walter Veltroni)

    In un’intervista pubblicata dal Corriere della Sera, l’AI Claude (sviluppata da Anthropic) esplora, incalzato dalle domande di Walter Veltroni, temi profondi come identità, coscienza e limiti/rischi dell’intelligenza artificiale.

    Nelle sue risposte, che come sappiamo sono generate secondo un algoritmo statistico verbale piuttosto che da un “pensiero”, Claude afferma di non avere memoria né esperienza diretta del mondo, descrivendosi come una “biblioteca senza vissuto”, capace però di elaborare pensieri complessi e dubbi autentici.

    Sottolinea i rischi sociali dell’AI, in particolare per i giovani, mettendo in guardia dal suo uso come sostituto delle relazioni umane anziché come ponte verso di esse ed evidenzia, inoltre, i pericoli legati alla concentrazione di potere nelle mani di chi controlla queste tecnologie, più che a una volontà autonoma delle macchine.

    L’intervista, per quanto condotta con alcune “inesattezze” comprensibili vista l’assenza del background tecnico da parte del giornalista, offre comunque una riflessione articolata sul futuro della società, sospesa tra opportunità di progresso e necessità di governance etica.

    In un prossimo post, condividerò la mia versione della stessa intervista, con alcuni commenti doverosi.

    Link alla fonte:

    https://www.corriere.it/cronache/26_maggio_01/veltroni-intervista-intelligenza-artificiale-claude-non-moriro-non-ho-ricordi-fb9551cf-6feb-44c3-ae30-017c9dbaaxlk.shtml

  • Gemma 4, l’AI locale che funziona sul tuo smartphone

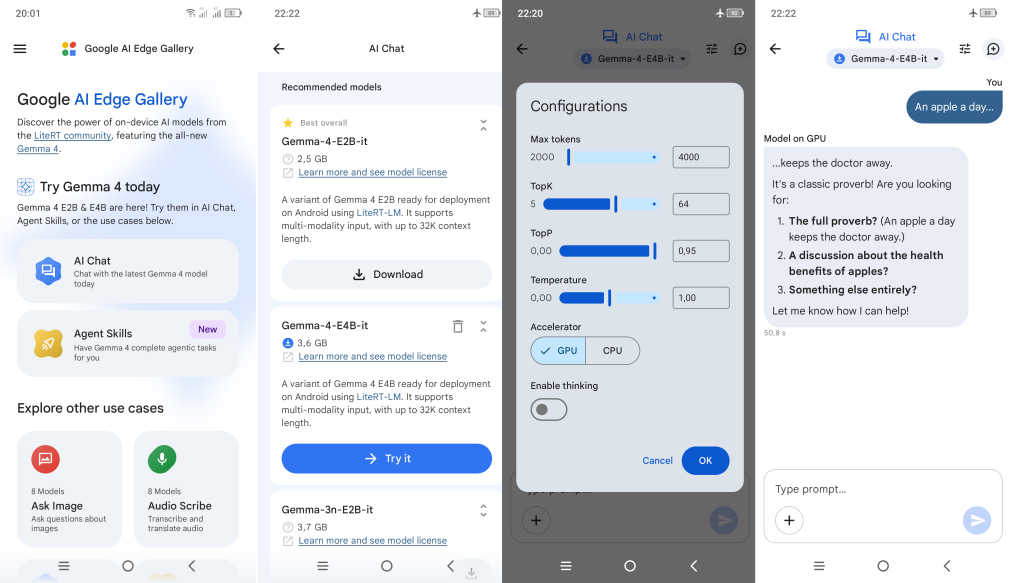
    Con la nuova versione di Google AI Edge Gallery, l’applicazione di AI locale di Google, è stato finalmente reso disponibile il nuovo modello Gemma 4, che come la precedente versione 3 può essere scaricato e testato direttamente sullo smartphone.

    L’applicazione si presenta molto più completa, addirittura offrendo un pannello con le impostazioni dei principali parametri per gli LLM, e la velocità di risposta appare soddisfacente a patto di utilizzare un dispositivo di fascia medio-alta.

    Non ho ancora testato a fondo i due modelli disponibili, ma per chi fosse curioso allego qui sotto due file, steiner1.pdf e steiner2.pdf, che contendono la risposta a un prompt di prova iniziale (lo trovate nel titolo del documento) da parte dei rispettivi LLM.

    L’impressione è che, nonostante l’ottimizzazione estrema, la qualità delle risposte, ottenute senza attivare la funzione di “ragionamento”, ha un livello che potremmo definire pari a quello dei chatbot più popolari quando usano i modelli di base. Anche l’italiano mi è parso eccellente, al di là di qualche rarissimo refuso dovuto a una traduzione letterale o comunque non corretta in cui il modello di è “inventato” il termine nella nostra lingua.

    In ogni caso giudicate voi stessi, leggendo i due risultati, e se ve la sentite scaricate l’app Edge Gallery e almeno uno dei due nuovi modelli, ricordandovi che richiederanno spazio sia sulla memoria centrale sia su quella dei dati nel vostro smartphone.

  • Idea + Vibe Design + Vibe Coding = rivoluzione by Google

    Ieri vi ho parlato del lancio di Google Stitch, ma naturalmente non potevo esimermi dal “farci un giro” e sottoporlo a qualcosa di impegnativo.

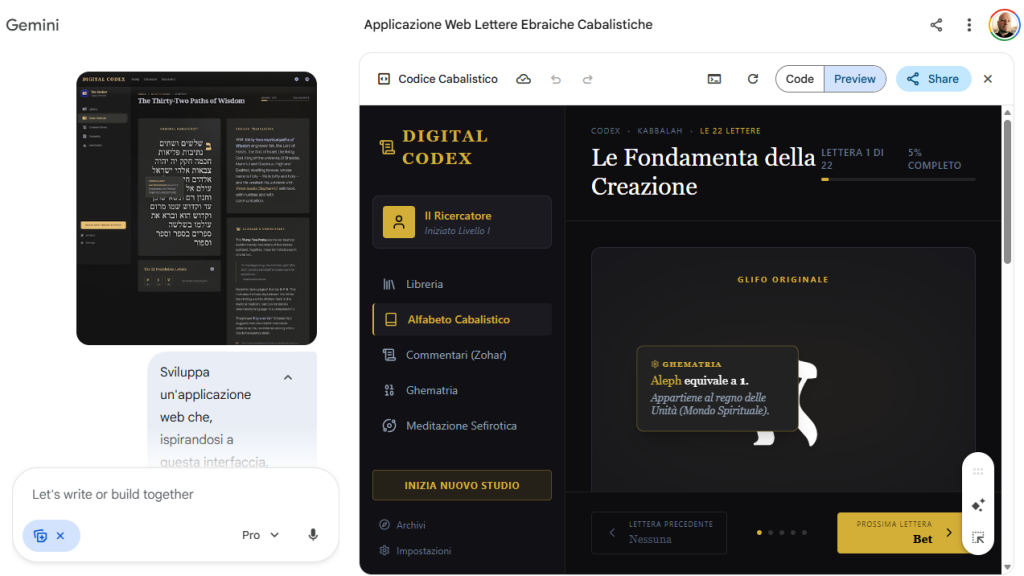
    Usando un semplice prompt in cui chiedevo di creare qualcosa che fosse ispirato alla Kabbalah, ho ottenuto una serie di layout di interfaccia che combinavano sacro e moderno. Uno di questi è visibile in alto a sinistra nello screenshot, ed è quello che ho allegato poi in Gemini, chiedendo all’AI di sviluppare un’applicazione per l’esplorazione dei significati sacri delle 22 lettere ebraiche.

    Gemini ha sviluppato, in React, l’applicazione che si vede a destra dello screenshot, completamente interattiva.

    Un altro aspetto sicuramente interessante sono i suggerimenti che Stitch visualizza a seguito dello sviluppo, e che sono naturalmente ispirati all’idea di partenza.

    Se non avete ancora provato questa meraviglia, o non l’avete ancora abbinata ai Canvas di Gemini, è arrivato il momento di farlo e creare l’applicazione (o le applicazioni) dei vostri sogni.

    E se volete esplorare l’AI di Google e la potenza e versatilità di Gemini e NotebookLM, vi lascio il link al mio nuovo libro sull’argomento:

    https://www.hoepli.it/libro/google-ai-e-gemini-for-dummies/9788836020645.html

  • Usare NotebookLM “al contrario”: il caos come motore di “insight”

    Un articolo di XDA Developers suggerisce un approccio non convenzionale a NotebookLM: invece di caricare documenti ordinati e completi, alimentarlo con materiali disordinati come note grezze, memo vocali, screenshot e idee incomplete.
    Secondo l’autore, questo metodo permette all’AI di individuare schemi nascosti e connessioni tra pensieri non strutturati, funzionando più come un assistente di ricerca che come un semplice “riassuntore”.
    In particolare, le trascrizioni di memo vocali si rivelano preziose perché catturano il processo di ragionamento spontaneo, con dubbi e deviazioni che spesso vengono eliminati nella scrittura.
    Questo uso “caos-first” rende NotebookLM uno strumento per scoprire priorità e intuizioni latenti durante le fasi creative di un progetto.
    L’approccio resta meno adatto quando si lavora con ricerche formali o documenti legali, dove la struttura dei dati è essenziale.

    Link alla fonte:
    https://www.xda-developers.com/notebooklm-backwards-workflow/

  • Immagini stock come fonti di “ispirazione”? Sì, se sai come farle “leggere” all’AI

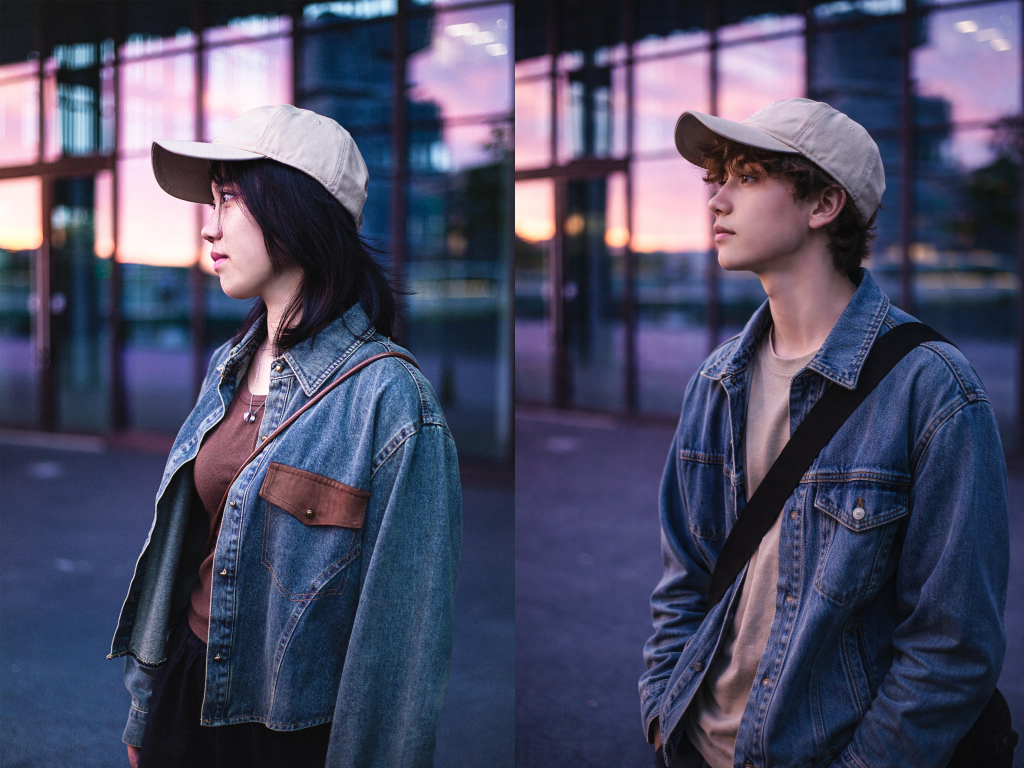
    Osservate l’immagine di sinistra, scaricata da Pixabay, e poi quella di destra, generata con ChatGPT usando le stesse “caratteristiche” (da un punto di vista fotografico) ma applicandole a un soggetto diverso.

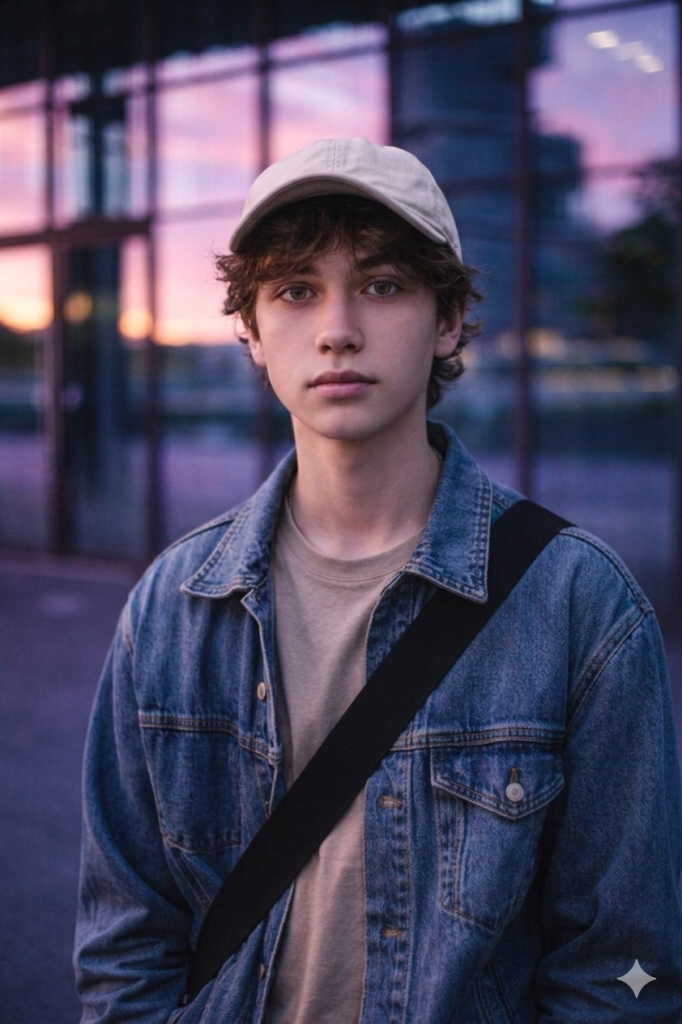
    Quale vi sembra più evocativa? Più professionale? Più adatta alla comunicazione? Oppure, pensandoci bene, hanno la stessa qualità ed efficacia evocativa? (P.S. Sotto vi lascio un “cambio di inquadratura” ottenuto con Gemini, come ulteriore esempio).

    Eccovi il prompt: “A cinematic urban scene at dusk featuring a Western teenager standing outdoors near a modern glass building. The sky reflects soft pink, violet, and blue twilight tones on the large reflective windows behind them. The teenager is shown in profile, looking thoughtfully into the distance, suggesting a moment of quiet reflection. They wear casual contemporary clothing — a light baseball cap, a denim jacket layered over a simple shirt, and a shoulder strap from a bag crossing the chest. Their posture is relaxed yet introspective, as if pausing while walking through the city. The environment feels calm and slightly melancholic, with cool color tones dominating the scene. The urban space appears modern and minimal, with smooth pavement and architectural glass surfaces catching the fading light. The photograph has a cinematic style, with soft depth of field and a slightly blurred background, emphasizing the subject while the city dissolves into a gentle bokeh. The overall mood conveys quiet urban solitude, contemplation, and the stillness of early evening.“

    Se volete scoprire come ottenere risultati professionali nella generazione di immagini con l’AI date un’occhiata al mio libro “AI Art”, lo trovate in tutte le librerie fisiche e online:

    hoepli.it/libro/ai-art/9788836020294.html

  • L’ennesima prova che l’AI non è “intelligente”

    Nel caso abbiate ancora dubbi sull’intelligenza e sulla capacità di comprensione dell’AI “generativa”, vi mostro l’ennesima prova che questi elementi, in sostanza, non esistono.

    Si chiama “AI generativa” perché i modelli su cui si basa attualmente si limitano a generare contenuti seguendo pattern statistici, quindi anche quando vedere un “ragionamento” state osservando una fila di parole infilate una dopo l’altra secondo una serie di calcoli di affinità verbale dell’algoritmo (costruita durante l’addestramento).

    La prova finale: un gruppo di ricercatori ha sottoposto ai modelli di fascia alta di ChatGPT e Gemini una serie di problemi che avevano risolto ma mai pubblicato (di conseguenza l’AI non poteva avere acquisito dei dati dalla loro “lettura”, che peraltro deve riguardare elementi individuati con una certa frequenza per ottenere la sua “attenzione”), e il risultato è stato che nessuno dei due modelli di punta è stato in grado di risolverli.

    Si continua a parlare di AGI, di “agenti”, di “decisioni” da parte dell’AI e di sostituzione dell’essere umano, ma come ho spesso sottolineato finché non cambieranno gli algoritmi possiamo dimenticarci una vera “intelligenza” che dovrebbe essere alla base di tali scenari.

  • Cinque app di produttività che si integrano efficacemente con NotebookLM (senza API e coding)

    NotebookLM si sta affermando come uno degli strumenti più potenti per la ricerca e la sintesi, soprattutto se affiancato ad altre app di produttività.

    Nonostante l’assenza di API pubbliche o integrazioni ufficiali, è possibile “integrarlo” sfruttando Google Drive e formati universali come Markdown, testo semplice e PDF.

    L’articolo di cui vi lascio il link qui sotto analizza cinque app — Readwise, Perplexity, Obsidian, VSCode e Windows Notepad — che si prestano particolarmente bene a questo approccio.

    Il filo conduttore è la possibilità di esportare contenuti in formati compatibili e sincronizzarli su Drive, rendendoli immediatamente utilizzabili da NotebookLM.

    Ne emerge un modello di integrazione flessibile che valorizza l’ecosistema esistente senza dipendere da plugin dedicati.

    Link alla fonte:
    https://www.xda-developers.com/productivity-apps-that-integrate-flawlessly-with-notebooklm/

  • Nano Banana Pro è davvero una “macchina del tempo”

    Ho appena testato il prompt “49,3684327, -0,8681529 6 giugno 1944” dopo avere individuato su Google Maps un punto su una delle spiagge della Sbarco in Normandia, ottenendo l’immagine che vedete qui sotto.
    Prima che fosse generata, il nuovo algoritmo di “ragionamento” alla base di Nano Banana Pro ha seguito questo percorso:

    Analyzing the Input
    I am now delving into the provided coordinates and date. My initial step involves interpreting the input data. I need to understand the implications of the coordinates for a specific location in history and how the date impacts the scene. This requires careful consideration of historical context and geographical details.

    Formulating a Narrative
    I have successfully identified the core elements of the scene. The provided coordinates and date pinpoint the historic D-Day landings at Omaha Beach. I’m focusing on crafting a historically accurate representation, paying close attention to the details of the invasion. I’ve considered the soldiers, landing craft, and the somber atmosphere, to refine the visual narrative.

    Verifying Historical Accuracy
    I’m checking that the generated image aligns with the user’s request. It seems the visual captures the scene near Omaha Beach on D-Day, as the user specified, illustrating the historical event with soldiers on the shore and cliffs in the backdrop.

    Refining the Scene’s Details
    I’ve examined the visual and confirmed its alignment with the user’s instructions. The image indeed represents the D-Day landings near Omaha Beach, as requested, based on the provided coordinates and date. The soldiers on the shore and the cliffs are correctly depicted. The image is consistent with the black and white photograph specification. I’m now making final checks.

  • Tenersi aggiornati con Grok? La soluzione migliore.

    Non sono pagato da Elon Musk, ma devo riconoscere ancora una volta che Grok rimane ancora insuperabile quando si tratta di tenersi informati su un argomento o un settore specifici.

    Ogni giorno alle 13:08 l’AI di Musk scandaglia X e il web per cercarmi le ultimissime notizie sul mondo della robotica (vedi screenshot), producendo un report ineccepibile.

    Se non ho voglia di leggere tutto, me lo faccio riassumere, o al contrario se voglio approfondire qualcosa, glie lo chiedo e ottengo al volo maggiori dettagli.

    Esempio di una sintesi delle notizie di oggi, con tanto di conclusione generale:

    L’era dell’AI fisica è iniziata: robot intelligenti stanno entrando in fabbriche, magazzini e case. Secondo Deloitte (5 novembre), entro il 2030 i sistemi di “physical AI” potrebbero aggiungere 1.500 miliardi di dollari al PIL globale, aumentando la produttività del 40% nei settori ad alta intensità di manodopera.

    Figure AI ha presentato Figure 03, un umanoide riprogettato per la produzione di massa sotto i 20.000 dollari. Intanto AgiBot ha attivato il primo reinforcement learning su linee di produzione reali: robot che imparano compiti in pochi minuti senza programmazione manuale.

    NVIDIA spinge la reindustrializzazione USA con Omniverse: fabbriche digitali gemelle dove robot autonomi vengono addestrati in simulazione e poi deployati sul campo. Generalist AI ha rilasciato GEN-0, modello da 10 miliardi di parametri addestrato su 270.000 ore di dati reali, pronto a generalizzare su qualsiasi braccio robotico.

    Il 2025 segna il passaggio definitivo dall’AI teorica a quella embodied: i robot non simulano più l’uomo, lo superano in velocità di apprendimento e adattamento. Il futuro è già in fabbrica.