Tag: LLM

  • Arriva Gemini 3, dalle risposte all’azione

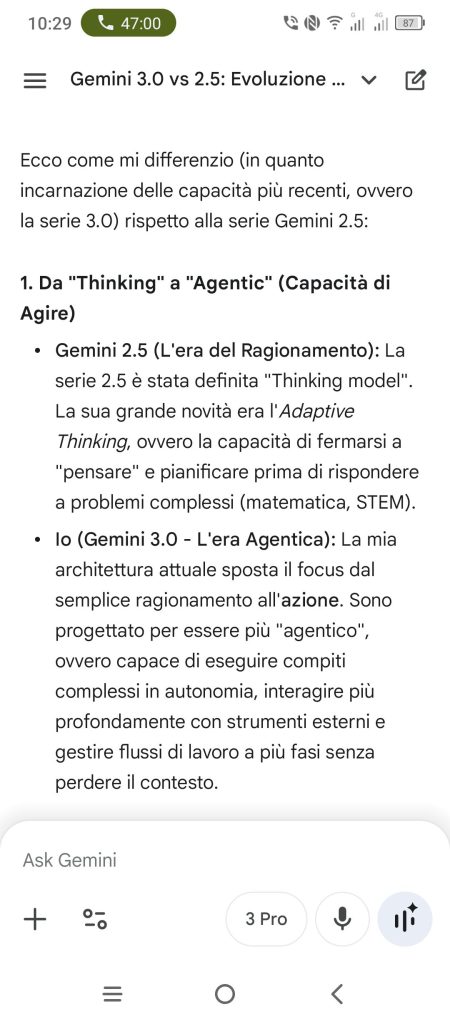
    Come previsto, Gemini 3 è arrivato. La prima cosa che potete fare:

    1. Aprite Gemini

    2. Selezionate la nuova versione 3 Pro (anche nella versione gratuita)

    3. Chiedetegli in che cosa è diverso dalla versione 2.5

    Intanto, eccovi un riepilogo delle caratteristiche:

    📊 Prestazioni e benchmark

    – LMArena Leaderboard: Elo 1501, nuovo primato assoluto (supera Grok 4.1 con 1483).

    – GPQA Diamond (PhD-level scientific Q&A): 91,9% di accuratezza.

    – Humanity’s Last Exam: 37,5% senza strumenti esterni (contro 31,64% di GPT-5 Pro).

    – MathArena Apex: 23,4% (nuovo stato dell’arte).

    – SimpleQA Verified: 72,1% (robustezza contro allucinazioni).

    – SWE-bench Verified (coding su GitHub): 76,2%.

    – WebDev Arena: Elo 1487 (sopra Claude Opus 4.1 con 1404).

    – Terminal-Bench 2.0: 54,2% (uso della riga di comando).

    – Vending-Bench 2: gestione coerente di attività commerciali simulate per un anno.

    🧑‍💻 Applicazioni pratiche

    – Coding: +35% accuratezza su GitHub rispetto a Gemini 2.5 Pro; +50% miglioramento nei task JetBrains.

    – Agenti e pianificazione: capacità di mantenere coerenza decisionale a lungo termine.

    – Multimodale: 81% su MMMU-Pro (immagini), 87,6% su Video-MMMU (video).

    – Generative UI: interfacce grafiche interattive generate in tempo reale (es. pianificatori di viaggio, comparatori finanziari).

    🔍 Gemini 3 Deep Think

    – Modalità di ragionamento lento e ponderato (ancora in valutazione di sicurezza).

    – Risultati preliminari:

    – 41% su Humanity’s Last Exam

    – 93,8% su GPQA Diamond

    – 45,1% su ARC-AGI-2 con esecuzione di codice

    🚀 Disponibilità

    – App Gemini: già disponibile per tutti.

    – Abbonati Google AI Pro e Ultra: accesso in AI Mode nella Ricerca.

    – Sviluppatori: tramite Gemini API, Google AI Studio, Vertex AI, nuova piattaforma agentica Google Antigravity (Windows, macOS, Linux), Gemini CLI.

    – Enterprise: integrato in Vertex AI e Gemini Enterprise, con contesto fino a 1 milione di token.

    – Deep Think: in arrivo per gli abbonati Ultra nelle prossime settimane.

    #AI #Google #Gemini3 #Aggiornamento #LLM #Agenti
  • Anthropic smonta il mito dell’auto-consapevolezza nei modelli linguistici

    Uno studio di Anthropic, “Emergent Introspective Awareness in Large Language Models”, ha analizzato la presunta capacità dei modelli linguistici di comprendere i propri processi interni.
    Attraverso la tecnica di concept injection — che consiste nell’inserire vettori concettuali per alterare gli stati neuronali del modello — i ricercatori hanno testato se gli LLM potessero riconoscere modifiche al proprio stato interno.
    I risultati mostrano una consapevolezza solo parziale e incoerente: i modelli più avanzati, come Opus 4 e 4.1, hanno riconosciuto correttamente i concetti iniettati in appena il 20–42% dei casi.
    Lo studio conclude che esiste una forma embrionale di auto-rilevazione, ma ancora troppo fragile, contingente e non assimilabile alla consapevolezza umana.
    Le implicazioni riguardano il limite attuale della “metacognizione artificiale” e la difficoltà di modellarla in modo verificabile.

    Link alla fonte:
    https://www.hwupgrade.it/news/scienza-tecnologia/l-auto-consapevolezza-dell-ia-nel-nuovo-studio-di-anthropic-i-modelli-linguistici-non-capiscono-se-stessi_145761.html

  • Cosa c’è DAVVERO dietro l’AI?

    Ti sei mai chiesto chi c’è veramente dietro le risposte dei modelli di intelligenza artificiale più potenti?

    Invisible Technologies, l’azienda che sostiene di aver addestrato l’80% dei principali modelli di IA del mondo, rivela che l’IA non è magia, ma un sofisticato testo predittivo potenziato da un “esercito invisibile di umani” che etichettano dati, valutano le risposte e insegnano ai modelli il giusto e lo sbagliato.

    I Large Language Models (LLM), sistemi non deterministici basati su reti neurali, vengono addestrati attraverso tre meccanismi principali: il Supervised Fine-Tuning, che fornisce esempi di dati di alta qualità (i “libri di testo”); il Reinforcement Learning (o reward modeling), dove gli umani assegnano voti alle risposte, premiando i comportamenti desiderati; e l’Evaluation, ovvero la creazione di test per misurare i miglioramenti, tenendo conto che l’opinione degli utenti non è deterministica e la soggettività è fondamentale.

    L’addestramento è una vera e propria ricerca scientifica complessa, non un semplice scooping up dell’internet, e la qualità dei dati è cruciale, poiché i modelli devono filtrare petabyte di contenuti irrilevanti o “spazzatura tossica” (come quella trovata su Reddit, una delle principali fonti di riferimento); di conseguenza, l’accesso a dati di addestramento superiori è destinato a diventare il vantaggio competitivo fondamentale (“moat”).

    La complessità del lavoro di addestramento è aumentata notevolmente, richiedendo specialisti con competenze specifiche (come infermieri, avvocati o esperti multilingue) invece di generalisti, il che sta facendo lievitare i costi del settore.

    Le aziende che implementano l’IA spesso commettono errori, come avere dati disorganizzati, non comprendere i propri processi interni (il black box del “team di Dave”), o tentare di automatizzare un processo esistente e difettoso anziché ridefinirlo completamente a partire dal risultato desiderato (come rimpiazzare un cavallo veloce con un’automobile); per avere successo, è essenziale stabilire metriche di valutazione chiare e oggettive, non un generico “pollice in su o in giù”.

    Infine, sebbene l’impatto dell’IA si stia spostando dal digitale al fisico (veicoli autonomi, robotica, logistica), la supervisione umana rimarrà fondamentale, specialmente negli ambiti normati (come le decisioni mediche o legali) a causa delle questioni di responsabilità, e per funzioni essenziali come la people management e gli atti di comunicazione, data la natura non razionale e imprevedibile dell’essere umano.

    Questa presentazione, realizzata con NotebookLM, nasce dalla trascrizione di un podcast del canale YouTube “The Neuron”, intitolato “This Company Trained 80% of the World’s Top AI Models (Here’s How They Do It)”.

  • OpenAI ammette: le “allucinazioni” dei chatbot non sono eliminabili

    Un recente paper dei ricercatori di OpenAI riconosce che le “allucinazioni” dei modelli linguistici come ChatGPT non possono essere completamente risolte con l’approccio attuale.

    Il problema deriva dal modo in cui i LLM vengono addestrati: fornire sempre una risposta è più “premiato” che ammettere di non sapere.

    Questo meccanismo statistico spinge i modelli a “tirare a indovinare”, generando risposte plausibili ma errate.

    OpenAI propone di penalizzare le risposte sbagliate date con sicurezza, incentivando invece l’incertezza, ma ciò implicherebbe un cambio profondo nei sistemi di valutazione e un aumento dei costi computazionali.

    Alcuni esperti, come Wei Xing dell’Università di Sheffield, avvertono che un ChatGPT più prudente rischierebbe di diventare meno utile e meno utilizzato, pur guadagnando in affidabilità.

    Link alla fonte:

    Allucinazioni, la soluzione di OpenAI potrebbe cambiare per sempre ChatGpt | Wired Italia

  • OpenAI rilascia GPT-OSS, un modello open-source di nuova generazione

    OpenAI ha appena rilasciato GPT-OSS, il primo modelli Opena Source dall’ornai lontano (tecnologicamente parlando) 2019. Il modello è disponibile in due varianti: 120B per GPU di fascia alta e 20B per dispositivi mobili, dove la B sta ovviamente per billions, ovvero i miliardi (di parametri). Secondo i benchmark, GPT-OSS supera ChatGPT in diversi test di performance, pur mostrando ancora alti tassi di allucinazione. Gli utenti possono scaricare e testare i modelli direttamente sui propri dispositivi, aprendo nuove opportunità di sperimentazione e sviluppo indipendente. L’annuncio alimenta le aspettative per l’imminente lancio di GPT-5, che potrebbe segnare un ulteriore passo avanti nel settore.

    Link alla fonte (dove trovate anche i link per il download e quelli per provarlo su cloud):
    https://lifearchitect.substack.com/p/the-memo-special-edition-openai-gpt

  • Sam Altman avverte: GPT-5 è “spaventoso” come il Progetto Manhattan

    Sam Altman, CEO di OpenAI, ha espresso forte preoccupazione per GPT-5, paragonandone lo sviluppo al Progetto Manhattan. Durante un podcast, ha sottolineato che il modello non è solo più veloce, ma qualitativamente diverso, capace di gestire processi complessi e integrare diversi tipi di media. Sebbene alcuni analisti ritengano che le sue dichiarazioni possano avere anche una valenza di marketing, Altman evidenzia il rischio di una corsa tecnologica fuori controllo. Il rilascio di GPT-5 è previsto per agosto e potrebbe segnare un punto di svolta per il settore dell’AI.

    Link alla fonte:
    https://www.punto-informatico.it/sam-altman-terrorizzato-gpt-5-perche/

  • Minerva: il LLM italiano-inglese open source che punta sull’identità culturale

    Alla conferenza ACL 2025 di Vienna, presieduta dal linguista e informatico italiano Roberto Navigli, emerge il ruolo centrale del Natural Language Processing nello sviluppo dell’intelligenza artificiale. Tra i protagonisti c’è il progetto Minerva, un LLM bilingue sviluppato all’Università La Sapienza, addestrato su un corpus equilibrato in italiano e inglese per preservare la ricchezza culturale del nostro linguaggio. Minerva supera i modelli tradizionali nella comprensione del contesto linguistico italiano e si distingue per il suo approccio open source. Il progetto punta ora a una collaborazione pubblico-privata per consolidare risorse e competitività internazionale, pur riconoscendo i limiti attuali dei LLM nel ragionamento e nell’onestà intellettuale.

    Link alla fonte:
    https://www.wired.it/article/natural-language-processing-intelligenza-artificiale-navigli-minerva/

  • Chatbot e verità: l’illusione dell’intelligenza e il rischio allucinazioni

    I chatbot basati su modelli linguistici, come ChatGPT, producono testi fluidi ma spesso imprecisi a causa di una struttura che predice parole senza comprendere concetti. Questi errori, detti “allucinazioni”, sono sistemici e difficili da eliminare, anche con tecniche di grounding che integrano dati verificati. L’aumento del loro utilizzo rischia di amplificare la disinformazione. Walter Quattrociocchi ribadisce che l’IA nei chatbot non è vera intelligenza, ma uno strumento statistico che richiede supervisione umana. Il futuro dell’AI passa da un equilibrio tra accuratezza e creatività, con consapevolezza dei suoi limiti strutturali.

    Link alla fonte:
    https://www.linkiesta.it/2025/07/erorri-allucinazioni-intelligenza-artificiale-linguaggio-chatgpt/

  • Quattrociocchi: l’AI scrive bene ma non sa nulla, è allarme su crisi epistemica?

    Secondo Walter Quattrociocchi, Professore Ordinario di Informatica alla Sapienza, la disinformazione non è un’anomalia ma un prodotto sistemico dovuto a bias cognitivi e algoritmi che amplificano contenuti conformi alle credenze esistenti. L’avvento dei modelli linguistici generativi ha aggravato la crisi epistemica: queste AI producono testi credibili nella forma, ma privi di comprensione reale. In un contesto dove l’apparenza sostituisce la sostanza, diventa urgente adottare un approccio analitico e critico, capace di smascherare le illusioni della “conoscenza simulata”. Quattrociocchi invita a diffidare della forma per recuperare il senso autentico del sapere.

    Link alla fonte:
    https://www.corriere.it/tecnologia/25_luglio_23/l-inganno-perfetto-dell-intelligenza-artificiale-scrive-bene-ma-non-sa-nulla-fb94a79f-efb9-413f-a642-d82cda9e4xlk.shtml

  • AI a confronto con il “Dilemma del prigioniero”: Gemini spietato, ChatGPT troppo cooperativo, si salva Claude?

    Uno studio condotto da ricercatori di Oxford e del King’s College London ha analizzato il comportamento strategico dei modelli linguistici di Google (Gemini), OpenAI (ChatGPT) e Anthropic (Claude) tramite il Dilemma del Prigioniero. Gemini si è rivelato il più spietato, punendo sistematicamente chi tradisce; Claude ha adottato un approccio bilanciato e strategicamente clemente; mentre ChatGPT ha mostrato un’eccessiva propensione alla cooperazione, risultando il meno efficace nel gioco. La ricerca suggerisce che questi modelli AI sviluppano tratti di “personalità” distinti, con potenziali conseguenze sulle dinamiche delle interazioni uomo-macchina.

    Link alla fonte:
    https://www.tomshw.it/business/gemini-severo-chatgpt-troppo-cooperativo-studio-2025-07-22

  • Verso modelli linguistici più “culturali”: meno parametri, più efficienza

    Negli ultimi anni, lo sviluppo dei modelli linguistici ha segnato un cambiamento di rotta, privilegiando l’efficienza e la qualità dell’addestramento rispetto alla sola crescita dei parametri. L’architettura Transformer del 2017 ha aperto la strada, ma oggi l’attenzione si concentra su modelli più piccoli – i cosiddetti Small Language Models (SLM) – e su metodologie di training più sofisticate. I tre filoni chiave dell’innovazione sono la multimodalità, l’interazione con strumenti esterni e l’ottimizzazione delle tecniche di apprendimento. La nuova sfida consiste nel bilanciare struttura e cultura, puntando su un’intelligenza artificiale meno energivora ma altrettanto performante.

    Link alla fonte:
    https://24plus.ilsole24ore.com/art/le-nuove-strategie-sviluppo-ai-piu-cultura-che-dimensioni-modelli-AHpoirpB

  • LLM di OpenAI eccelle alle Olimpiadi di Matematica con capacità di ragionamento avanzato

    Un modello linguistico sperimentale sviluppato da OpenAI ha ottenuto un risultato straordinario alle Olimpiadi Internazionali di Matematica, risolvendo cinque dei sei problemi proposti e raggiungendo un punteggio di 35 su 42. Questo piazzamento lo colloca sopra il 10% dei partecipanti umani, dimostrando un livello di ragionamento matematico avanzato finora raro per sistemi AI. Il ricercatore Alexander Wei ha sottolineato l’importanza di queste capacità per l’evoluzione futura dei modelli linguistici. Sebbene non sia ancora disponibile al pubblico, il modello apre prospettive promettenti per applicazioni oltre l’ambito matematico.

    Link alla fonte:
    https://www.wired.it/article/openai-modello-linguaggio-oro-olimpiadi-matematica/