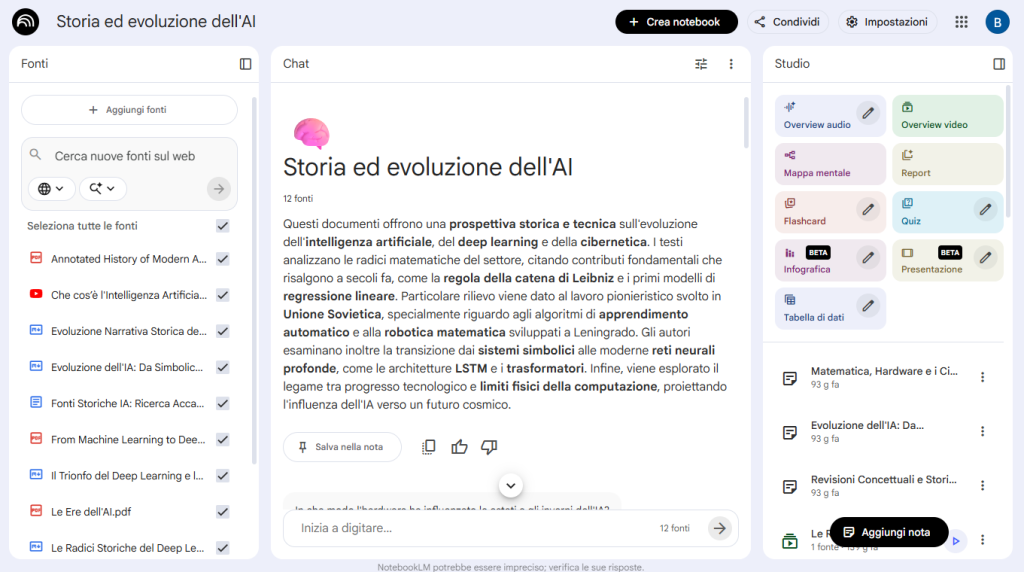
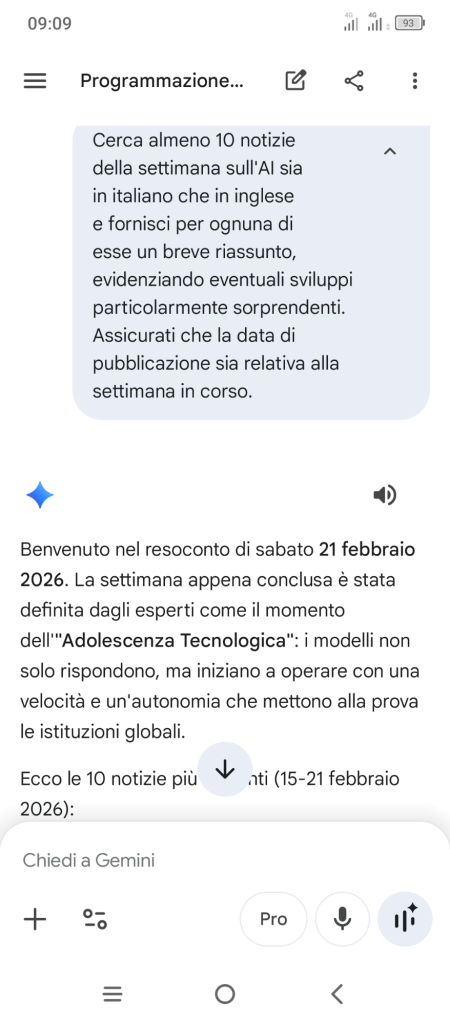
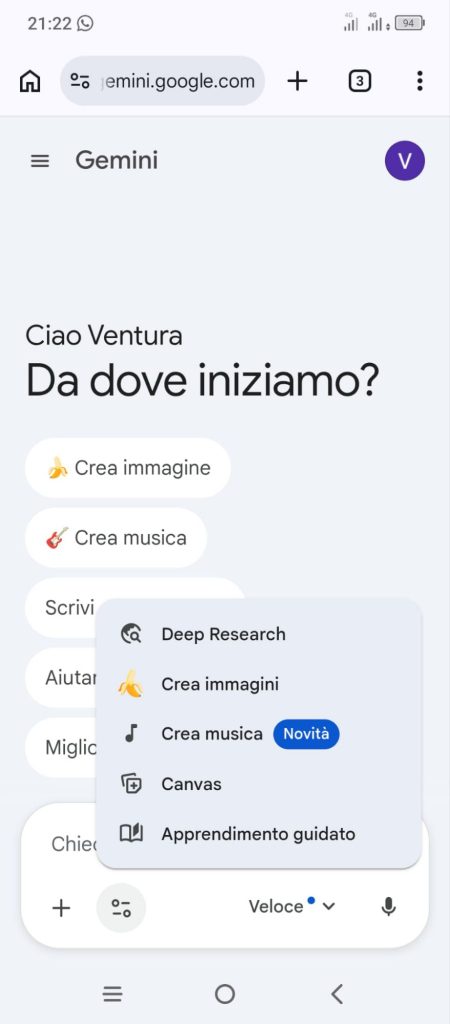
Google ha annunciato l’introduzione dei notebook all’interno di Gemini, trasformando l’assistente in uno strumento avanzato di gestione della conoscenza. I notebook – equivalenti dei “progetti” di altri chatbot come ChatGPT e Claude – permettono di organizzare chat, file e fonti in spazi dedicati, appunto, a singoli progetti specifici, migliorando coerenza e continuità delle interazioni con l’IA. La forte integrazione con NotebookLM consente una sincronizzazione automatica dei contenuti tra piattaforme, rendendo più fluido il passaggio tra analisi, sintesi e produzione di contenuti. Gli utenti possono inoltre personalizzare fonti, tono e memoria del contesto, aumentando il controllo sull’output dell’IA. Questa novità segna un passo importante verso un utilizzo più strutturato e produttivo dell’intelligenza artificiale.
Anthropic ha stretto un accordo strategico con Google e Broadcom per garantirsi almeno 3,5 GW di capacità computazionale basata su TPU a partire dal 2027, assicurando risorse cruciali per la crescita del modello Claude. L’intesa arriva mentre il fatturato annuale dell’azienda supera i 30 miliardi di dollari nel 2026, trainato da un rapido aumento dei clienti enterprise. Broadcom fornirà i chip progettati da Google, con un contratto valido fino al 2031, e gran parte dell’infrastruttura sarà costruita negli Stati Uniti. L’operazione riflette la necessità di anticipare colli di bottiglia nella disponibilità di calcolo, sempre più critici nel settore AI. Anthropic continua inoltre a diversificare l’hardware utilizzato, mantenendo Amazon AWS come partner principale per il training.
Alphabet Inc. ha scosso il mercato dei semiconduttori presentando TurboQuant, un algoritmo di IA capace di ridurre drasticamente l’uso di memoria nei modelli linguistici. L’annuncio ha provocato un sell-off immediato nei titoli legati alle memorie, tra cui Samsung Electronics, SK Hynix e Micron Technology, a causa del timore di una futura domanda più debole di chip. Tuttavia, diversi analisti ritengono che il mercato stia reagendo in modo eccessivo, sottolineando che una maggiore efficienza potrebbe ridurre i costi e accelerare l’adozione dell’IA. In particolare, Morgan Stanley evidenzia come la tecnologia possa ampliare i casi d’uso e aumentare la domanda complessiva nel lungo periodo. Il ribasso attuale viene quindi interpretato da alcuni investitori come una potenziale opportunità di acquisto strategico.
I ricercatori di Google Research presentano TurboQuant, un nuovo algoritmo di quantizzazione progettato per comprimere drasticamente i modelli AI senza perdita di accuratezza.
La tecnica combina due innovazioni — QJL e PolarQuant — per ridurre fino a 6 volte la memoria del key-value cache, migliorando al contempo velocità e prestazioni nei modelli linguistici.
TurboQuant riesce a operare con rappresentazioni a soli 3 bit mantenendo risultati equivalenti ai modelli non compressi, con accelerazioni fino a 8x su GPU.
Questo approccio ha implicazioni cruciali per il futuro della ricerca semantica e degli LLM su larga scala, rendendo possibile gestire enormi quantità di dati con maggiore efficienza. Il lavoro, che sarà presentato a ICLR 2026 e AISTATS 2026, rappresenta un avanzamento teorico e pratico nella compressione vettoriale.
Ieri vi ho parlato del lancio di Google Stitch, ma naturalmente non potevo esimermi dal “farci un giro” e sottoporlo a qualcosa di impegnativo.
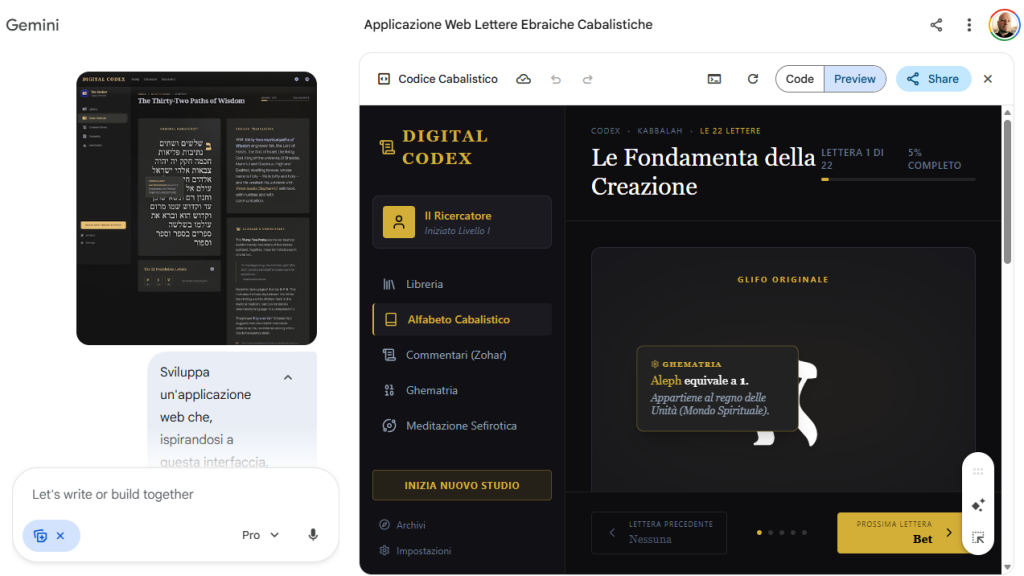
Usando un semplice prompt in cui chiedevo di creare qualcosa che fosse ispirato alla Kabbalah, ho ottenuto una serie di layout di interfaccia che combinavano sacro e moderno. Uno di questi è visibile in alto a sinistra nello screenshot, ed è quello che ho allegato poi in Gemini, chiedendo all’AI di sviluppare un’applicazione per l’esplorazione dei significati sacri delle 22 lettere ebraiche.
Gemini ha sviluppato, in React, l’applicazione che si vede a destra dello screenshot, completamente interattiva.
Un altro aspetto sicuramente interessante sono i suggerimenti che Stitch visualizza a seguito dello sviluppo, e che sono naturalmente ispirati all’idea di partenza.
Se non avete ancora provato questa meraviglia, o non l’avete ancora abbinata ai Canvas di Gemini, è arrivato il momento di farlo e creare l’applicazione (o le applicazioni) dei vostri sogni.
E se volete esplorare l’AI di Google e la potenza e versatilità di Gemini e NotebookLM, vi lascio il link al mio nuovo libro sull’argomento:
Google aggiorna Stitch, il suo strumento sperimentale di design AI presentato al Google I/O 2025, introducendo il concetto di “vibe design”, che consente di creare interfacce partendo da emozioni e input astratti anziché da wireframe tradizionali. L’integrazione con Gemini Live permette agli utenti di dialogare vocalmente con la canvas, ricevendo suggerimenti, modifiche in tempo reale e persino interviste guidate per definire il design. Il sistema include anche un agente di design e un Agent Manager per gestire progetti complessi e collaborativi. Tra le funzionalità avanzate figurano l’estrazione automatica di design system da URL e la sincronizzazione tramite file DESIGN.md con altri strumenti. Stitch completa il flusso trasformando design statici in prototipi interattivi, segnando un possibile cambio radicale nel modo in cui si progettano le interfacce digitali.
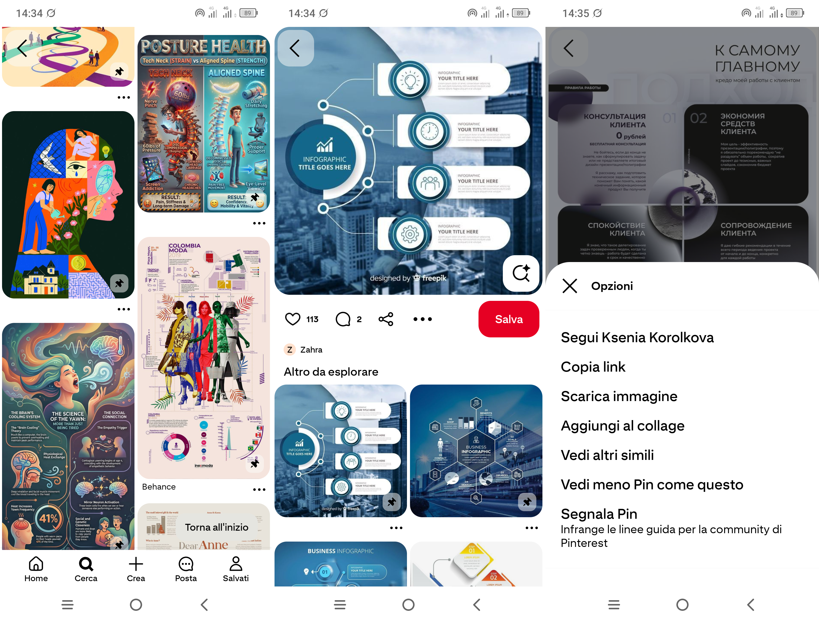
Leggendo un post di Axelle Malek (di cui vi lascio come sempre il link sotto) ho appena scoperto come attingere a una vera miniera d’oro visuale, ovvero le infografiche su Pinterest, per scoprire nuovi stili da dare in pasto a Gemini affinché ne estragga il “concept” e lo impieghi per rappresentare i miei dati.
In Pinterest non solo puoi sfogliare all’infinito i risultati della semplice ricerca “infografiche”, ma anche mettere nei “preferiti” quelli che ti piacciono di più o salvarle come file, seguire l’autore, oppure cercare altre infografiche dallo stile simile (vedi il menu nella terza immagine in basso).
Per il resto, vi lascio al post da cui sono partito, per scoprire altre interessanti strategie per il vostro lavoro sulle infografiche:
Un articolo di XDA Developers suggerisce un approccio non convenzionale a NotebookLM: invece di caricare documenti ordinati e completi, alimentarlo con materiali disordinati come note grezze, memo vocali, screenshot e idee incomplete. Secondo l’autore, questo metodo permette all’AI di individuare schemi nascosti e connessioni tra pensieri non strutturati, funzionando più come un assistente di ricerca che come un semplice “riassuntore”. In particolare, le trascrizioni di memo vocali si rivelano preziose perché catturano il processo di ragionamento spontaneo, con dubbi e deviazioni che spesso vengono eliminati nella scrittura. Questo uso “caos-first” rende NotebookLM uno strumento per scoprire priorità e intuizioni latenti durante le fasi creative di un progetto. L’approccio resta meno adatto quando si lavora con ricerche formali o documenti legali, dove la struttura dei dati è essenziale.
NotebookLM introduce i Cinematic Video Overviews, una nuova funzione che espande le precedenti Video Overviews trasformandole in veri e propri video immersivi generati dall’AI. Il sistema utilizza una combinazione di modelli avanzati di Gemini, Veo e Nano Banana Pro per creare animazioni fluide e visual ricchi a partire dalle fonti dell’utente. Gemini assume il ruolo di “creative director”, prendendo centinaia di decisioni narrative e stilistiche per costruire la storia, scegliere lo stile visivo e mantenere la coerenza del video. Il risultato sono contenuti più dinamici e coinvolgenti rispetto alle precedenti presentazioni con slide narrate. La funzionalità è disponibile inizialmente in inglese per gli abbonati Google AI Ultra (18+) su web e mobile.
Google e OpenAI hanno presentato quasi in parallelo due aggiornamenti ai loro modelli di intelligenza artificiale con l’obiettivo di migliorare efficienza, velocità e qualità delle risposte. Google ha introdotto Gemini 3.1 Flash-Lite, un modello progettato per applicazioni su larga scala che offre costi molto ridotti per milione di token e prestazioni più rapide rispetto alla generazione precedente, rendendolo adatto a traduzioni massive, moderazione dei contenuti e automazioni in tempo reale. Parallelamente OpenAI ha rilasciato GPT-5.3 Instant, focalizzato sul miglioramento dell’esperienza conversazionale: risposte più naturali, meno premesse difensive e una riduzione significativa delle allucinazioni nei test interni. L’aggiornamento introduce anche una migliore integrazione tra ricerca web e ragionamento del modello, con risposte più pertinenti e sintetiche. Le due novità evidenziano una tendenza comune nel settore: rendere i modelli AI non solo più potenti, ma anche più economici, affidabili e adatti all’uso quotidiano da parte di sviluppatori, aziende e utenti finali.
Nel mio libro “AI Art”, pubblicato a giugno dell’anno scorso, per chi volesse ottenere risultati veramente professionali suggerivo Midjourney come piattaforma in grado di offrire una qualità ineguagliabile (allora), anche se disponibile solo a pagamento.
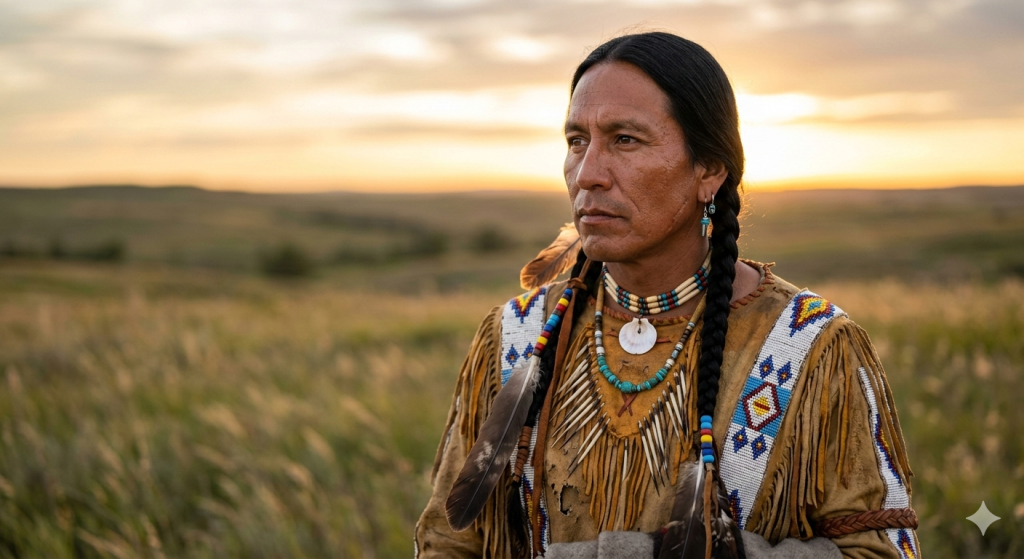
Google ha appena aggiornato il suo modello grafico, e direi che Midjourney ha le ore contate (per fortuna i principi che espongo nel libro sono validi a prescindere dalla piattaforma).
Eccovi un esempio di immagine generata dal nuovo Nano Banana con questo prompt: “Ritratto fotorealistico di un guerriero nativo americano di circa 40 anni, con pelle ramata segnata dal sole e sottili linee d’espressione, capelli lunghi e lisci color nero corvino raccolti in una treccia, occhi profondi e contemplativi. Indossa abiti tradizionali in pelle scamosciata decorati con perline artigianali e piume naturali, dai toni terra e ocra. Luce calda dell’ora dorata proveniente da destra, bassa sull’orizzonte, che crea un contrasto morbido e un’illuminazione pittorica in stile Rembrandt, enfatizzando la texture della pelle e dei materiali. Scattato con Nikon Z9 e obiettivo 85mm f/1.4. Profondità di campo ridotta, sfondo sfocato di una prateria aperta con erba alta mossa dal vento.”
NotebookLM si evolve in silenzio rivelandosi ancora una volta come la una delle piattaforme di AI generativa più interessanti e utili per studio e ricerca
Gli ultimi aggiornamenti di NotebookLM sono stati descritti come fra i più significativi dal lancio, introducendo miglioramenti sia nelle capacità di analisi che nelle opzioni di creazione. Proverò a riassumervi le novità:
– Capacità di contesto aumentata: il sistema è stato ricostruito per elaborare una quantità di materiale sorgente otto volte superiore in una singola conversazione. Questo permette all’IA di consultare tutte le fonti contemporaneamente invece di selezionarne solo alcune parti.
– Memoria della conversazione: la memoria è diventata sei volte più lunga, consentendo interazioni complesse senza che l’IA dimentichi l’inizio della chat.
– Qualità delle risposte: miglioramento del 50% nella qualità delle risposte per le grandi raccolte di fonti, rendendole più nitide e specifiche.
– Il limite dei caratteri per le istruzioni personalizzate è passato da 500 a 10.000 caratteri (un aumento di 20 volte): NotebookLM diventa così un vero e proprio assistente di ricerca specializzato, personalizzabile in dettaglio nel tono, nel “modo di pensare” e nel formato delle risposte.
– Oltre al classico formato “Deep Dive”, l’Audio Overview offre ora tre nuove modalità per generare podcast dai propri documenti: Brief, un riassunto veloce di 1-2 minuti per comprendere rapidamente i punti salienti; Critique, in cui due host analizzano le fonti evidenziando punti deboli, lacune argomentative o prove mancanti e Debate, nel quale gli host assumono posizioni opposte su un tema estratto dalle fonti (utile per visualizzare diversi punti di vista quando i documenti non concordano tra loro). È inoltre possibile fornire istruzioni personalizzate specifiche anche per la generazione di questi file audio.
– Data Tables: una nuova funzione nel pannello Studio permette di creare tabelle di confronto strutturate estraendo dati direttamente dalle fonti. Queste tabelle sono esportabili in Google Sheets con un clic.
– Controllo creativo sui “visual”: per le infografiche e le slide è ora possibile scegliere l’orientamento (orizzontale, verticale o quadrato), il livello di dettaglio e utilizzare un prompt personalizzato per descrivere l’estetica desiderata (ad esempio, uno stile editoriale o minimalista). Inoltre, è ora possibile usare i prompt per modificare le slide.
– È ora possibile collegare i propri notebook direttamente all’app Gemini: i notebook possono essere utilizzati come fonti all’interno di Gemini o aggiunti ai Gem personalizzati, permettendo di utilizzare le fonti verificate di NotebookLM per compiti di scrittura creativa o analisi avanzata all’interno dell’ecosistema Gemini.
Fra due settimane sarà disponibile in tutte le librerie fisiche e online il mio nuovo manuale sull’ecosistema AI di Google, con capitoli dedicati proprio a NotebookLM, puoi già pre-ordinaro su Amazon:
Google amplia le capacità creative di Gemini introducendo modelli video predefiniti che permettono di trasformare foto o descrizioni testuali in clip pronte all’uso, riducendo la necessità di prompt complessi. La nuova sezione “Crea video” integra stili guidati e si collega alla funzione Ingredients to Video, ora compatibile anche con il formato verticale 9:16. La generazione video si basa sul modello Veo 3.1, con limiti giornalieri differenziati per i piani AI Plus, Pro e Ultra. In parallelo, Google chiarisce anche le soglie per la musica generata con Lyria 3, delineando un ecosistema creativo strutturato ma regolato da contatori precisi. L’obiettivo è consolidare Gemini come piattaforma completa per la produzione multimediale AI, bilanciando semplicità d’uso e controllo delle risorse.
Colossi della Silicon Valley come OpenAI, Google e Anthropic stanno accelerando la creazione di proprie accademie e piattaforme formative, con l’obiettivo di formare direttamente sviluppatori e professionisti dell’intelligenza artificiale. Iniziative come Claude 101 di Anthropic, OpenAI Academy e Google Cloud Skills Boost offrono percorsi strutturati e certificazioni ufficiali che rischiano di diventare più influenti di una laurea tradizionale nel settore tech Questo spostamento del baricentro educativo verso soggetti privati nasce anche dalla lentezza dei sistemi pubblici nell’integrare l’alfabetizzazione algoritmica nei programmi di studio. Il risultato potrebbe essere un nuovo monopolio globale della formazione, dove le Big Tech non solo controllano gli strumenti e i dati, ma anche i criteri di certificazione delle competenze. Le implicazioni toccano occupazione, equità nell’accesso al sapere e autonomia delle istituzioni accademiche.
Poco fa Gemini mi ha fornito il suo resoconto settimanale sulle ultime notizie di tecnologia, basato sulle mie istruzioni, e ho potuto farglielo “leggere” semplicemente facendo clic sull’icona dell’altoparlante, come fosse un podcast.
Anche in questo caso, come sempre, è l’efficacia del prompt che fa la differenza, e quello che ho usato per il test non è neanche tanto elaborato, eppure il risultato è già soddisfacente.
E voi, per cosa usate già o vorreste usare la pianificazione nel vostro chatbot abituale?
Lyria 3 è il modello di intelligenza artificiale più avanzato sviluppato da Google DeepMind per la generazione di musica. È stato rilasciato proprio oggi, 18 febbraio 2026, ed è integrato direttamente nell’app Gemini (e sul web), permettendo a chiunque (maggiorenni) di creare tracce musicali originali di 30 secondi in modo molto semplice. Il rollout è graduale, e inizialmente sarà disponibile nella versione su browser, poi nell’app mobile di Gemini. Principali caratteristiche di Lyria 3: – Trasforma prompt testuali in brani completi (testo + musica + voce) – Accetta anche immagini o video come input: Gemini genera una canzone che “si ispira” al mood o al contenuto visivo – Genera automaticamente i testi (non serve più scriverli a mano come nelle versioni precedenti) – Puoi controllare genere, stile, mood, tempo, tipo di voce, strumentazione… – Qualità audio dichiarata molto alta: meno artefatti rispetto a concorrenti tipo Suno, suono più naturale e complesso – Progettato per creazione originale: non imita letteralmente artisti esistenti (se metti un nome tipo “nello stile di Taylor Swift” ma lo prende come ispirazione generica mood/stile, non copia) – Ci sono filtri anti-copyright e watermark digitali per tutelare i diritti.
Secondo un rapporto del Google Threat Intelligence Group, gruppi APT (Advanced Persistent Threat, ossia organizzazioni di hacker altamente strutturate e spesso sponsorizzate da Stati, specializzate in attacchi mirati e di lunga durata) legati a Cina, Iran, Corea del Nord e Russia stanno sfruttando in modo sistematico il modello Gemini per potenziare le proprie operazioni cyber offensive. Tra i casi documentati figurano attori cinesi come APT31 e Temp.HEX, che avrebbero utilizzato l’AI per analisi di vulnerabilità, tecniche di Remote Code Execution e bypass dei firewall applicativi. L’iraniano APT42 avrebbe invece impiegato Gemini per accelerare lo sviluppo e il debugging di strumenti malevoli. Il report evidenzia anche malware AI-nativi come HonestCue, che genera payload C# fileless tramite API, e CoinBait, kit phishing costruito con strumenti di code generation. Oltre all’uso offensivo, Google segnala tentativi su larga scala di distillazione del modello, configurando un furto di proprietà intellettuale che alimenta la crescente corsa agli armamenti nell’AI.
Google ha avviato l’accesso a Project Genie, una piattaforma di intelligenza artificiale capace di generare mondi digitali interattivi a partire da semplici prompt testuali o immagini, causando reazioni immediate nei mercati e tra i grandi publisher di videogiochi.
Basato sul modello Genie 3, il sistema permette di esplorare ambienti dinamici in tempo reale, simulando fisica e interazioni senza l’uso dei tradizionali motori come quelli di Epic Games o Unity Technologies.
Alcuni utenti hanno già creato cloni ispirati a titoli celebri come Grand Theft Auto e The Legend of Zelda, sollevando interrogativi legali sulla tutela della proprietà intellettuale. Secondo esperti accademici e manager di Google DeepMind, la tecnologia potrebbe ridurre drasticamente tempi e costi di sviluppo, pur restando al momento un prototipo sperimentale con limiti tecnici.
L’iniziativa segnala un possibile cambio di paradigma nello sviluppo videoludico, con l’AI non solo come acceleratore dei processi, ma come nuovo strumento creativo centrale.